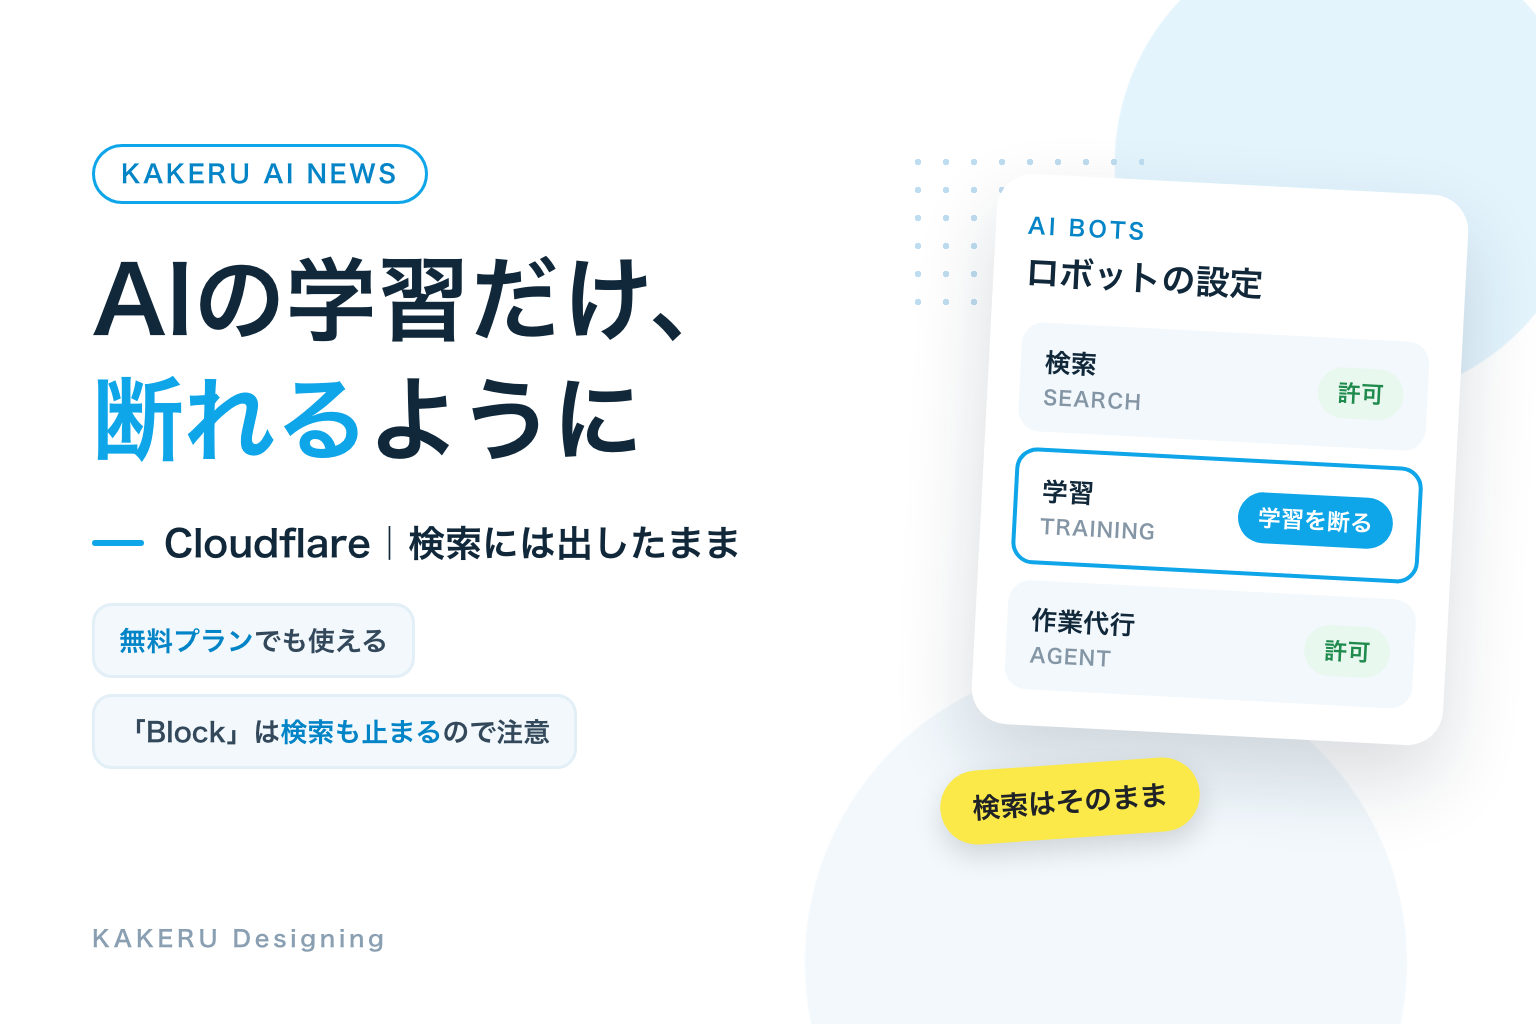
Cloudflare(クラウドフレア。サイトを速く・安全に届けるためのサービス)に、「検索結果には出したまま、AIの学習だけを断る」設定が加わりました。2026年9月15日の発表です。
これまで、GoogleやAppleなどの一部のロボットは、検索とAIの学習を同じロボットで行っていました。そのため「AIには使われたくない」と断ると、検索にも出にくくなる、という板ばさみがありました。今回の更新は、そこを分けて選べるようにしたものです。
先に書いておくと、これはCloudflareを使っているサイトの話です。使っていないサイトには、直接は関係しません。この記事では、Cloudflareの公式発表で確認できたことだけを使って、何が変わったのか、WEB担当者は何を確かめればいいのかを整理します。
何が発表された?|AIのロボットを「3つの目的」に分けて扱えるように
Cloudflareは2026年9月15日、公式ブログとプレスリリースで、サイトに来るAIのロボットの扱い方を新しくしたと発表しました。
ロボットは、サイトを見に来る目的によって3つに分けられています。

そのうえで、学習にだけ使える新しい選択肢「Disallow AI Training」が加わりました。これを選ぶと、「学習には使わないでほしい」という意思表示がrobots.txt(ロボットに向けてサイトのルールを書いておくファイル)に書き込まれます。
公式ブログによると、この設定では、後で説明する「Accountable」とされた検索用のロボットは、これまでどおり検索のためにサイトを見に来られます。それ以外の学習用ロボットはブロックされます。Amazon・Anthropic・Meta・OpenAIの学習専用のロボットも対象で、これらをブロックしても検索には影響しないと説明されています。
新しい設定は、無料プランを含むすべてのプランで使えます。設定する場所は、ドメインごとの「Security Settings」です。
これまでと何が違う?|「断るなら、検索もあきらめる」しかなかった
問題の出発点は、検索と学習を1つのロボットでこなしている会社があることでした。公式ブログでは、こうしたロボットを「mixed-use crawler(兼用のロボット)」と呼んでいます。GoogleのGooglebot、AppleのApplebot、MicrosoftのBingbotがその例として挙げられています。
兼用のロボットを断ると、学習だけでなく検索にも出にくくなります。逆に検索のために受け入れると、学習にも使われる可能性がある。サイトの持ち主は、どちらかを選ぶしかありませんでした。
公式ブログによると、Cloudflareを使っているサイトのうち、検索用のロボットをブロックしているのは1%未満。一方で、学習をなんらかの形で止めているサイトは17%あります。検索は歓迎、学習は止めたい、という人が一定数いることが、今回の更新の理由として説明されています。
| これまで | 2026年9月15日から | |
|---|---|---|
| 兼用のロボット(Googlebotなど) | 受け入れるか、断るかの二択 | 「検索は受け入れて、学習は断る」を選べる |
| 学習専用のロボット | 断れる | 断れる(検索には影響しない) |
| robots.txtへの反映 | 自分で書くか、別の機能で管理 | 設定に合わせて自動で書き込まれる |
何ができるようになった?
学習だけを断る「Disallow AI Training」
学習(Training)の設定は、「Allow(許可)」か「Disallow AI Training(学習を断る)」から選びます。Disallow AI Trainingは学習の設定にだけある選択肢で、検索や作業代行の設定にはありません。
robots.txtに自動で書き込む「Bot Preference Sync」
選んだ設定は、「Bot Preference Sync」という機能でrobots.txtに自動で反映されます。この機能は2026年8月21日に発表されたもので、今回の設定の土台になっています。
公式ブログによると、今あるrobots.txtは上書きされず、先頭に書き足される形で、すでに書いてあるルールは残ります。書き足した部分には「# BEGIN Cloudflare Bot Preference Sync」という目印が付きます。
「Accountable(責任ある)」という区別ができた
Cloudflareは、兼用のロボットを動かしている会社のうち、次の条件を満たしている、または満たすと約束している会社を「Accountable」と呼ぶことにしました。
- robots.txtなどで、学習を断る方法がある
- AIの要約に使われることを断る方法がある(Cloudflareからの設定は来年の予定)
- どのページが学習に使われたか、検索でどう表示されたかをURL単位で確認できる
- 学習を断っても、通常の検索結果には影響しないと保証している
公式ブログでは、Apple・Google・Microsoftがこの条件を満たすとされています。今できることと、開発中のものについて期限を決めた約束の組み合わせです。また、Amazon・Anthropic・Meta・OpenAIのロボットも、検索用と学習用を分けているため、学習用だけを止めても検索に影響しないとしてAccountableに分類されています。
新しく登録するドメインには、2つのおすすめ設定
9月15日から、Cloudflareに新しくドメインを登録するときは、広告で収益を得ているかどうかで2通りのおすすめ設定が示されます。

広告の収益は、人が実際にページを見ることで生まれます。学習はそのページを「答え」に置き換えてしまい、作業代行のAIは誰も見ていない状態でページを読みます。そのため、広告のあるサイトには厳しめの設定がすすめられている、と説明されています。どちらの設定も、登録のときや後から変更できます。
仕事ではどう使えそう?
ここからは、公式発表の内容をもとにした、KAKERUデザインとしての見立てです。
まず「うちのサイトはCloudflareを使っているか」を確かめる
会社のサイトがCloudflareを使っているかどうかは、担当者でも知らないことがよくあります。サーバーやドメインの管理を制作会社に任せている場合は、まず制作会社に聞いてみるのが早いです。
「AIに使われたくない」と言われたら、決めるのは会社の方針
今回の更新で、「検索は残して、学習だけ断る」という選び方ができるようになりました。ただ、学習を断るのがいいかどうかは、会社によって答えが違います。
たとえば、自社の商品やサービスをAIの回答の中でも紹介してほしい会社なら、学習を許可しておくほうが合っているかもしれません。独自の記事やデータが商品そのものになっている会社なら、断りたいと考えるはずです。設定は数クリックでも、決めるのは人です。
Cloudflareを使っていないサイトは
今回の設定は使えませんが、公式ブログには各社の断り方も書かれています。GoogleはGooglebotの学習を、robots.txtで「Google-Extended」を指定して断れます。Appleは「Applebot-Extended」です。自分でrobots.txtを編集できるなら、この方法があります。
KAKERUのサイトはCloudflareを使っていないので、今回の設定は試せません。自分のサイトのrobots.txtに何が書いてあるか、一度見直すきっかけにはなりそうです。
誰が使える?
| 項目 | 公式発表の内容 |
|---|---|
| 対象 | Cloudflareを使っているすべてのお客様 |
| プラン | 無料プランを含むすべてのプラン |
| 設定する場所 | ドメイン(ゾーン)ごとの「Security Settings」 |
| 開始 | 2026年9月15日 |
| 今の設定 | ほとんどの場合、何もしなくても新しい設定に引き継がれる |
公式ブログは英語のほか、ドイツ語とオランダ語で公開されています。日本語の管理画面でどう表示されるかは、今回の発表では確認できませんでした。
注意点
「Block(ブロック)」を選ぶと、検索にも出なくなる
ここがいちばん大事な変更です。9月15日から、「Block」と「Block on pages with ads(広告のあるページでブロック)」は、兼用のロボットにも効くようになりました。公式ブログには、Blockを選ぶとApplebot・Bingbot・Googlebotがサイトに来られなくなり、検索も含めて止まると書かれています。
「学習は止めたいけれど、検索は残したい」なら、選ぶのはBlockではなく「Disallow AI Training」です。言葉が似ているので、設定するときは注意してください。

Bingには、まだ「学習を断る」が伝わらない
公式ブログによると、Microsoftはrobots.txtの「学習を断る」を読み取る仕組みを開発中で、2027年の初めを目標にしています。それまでは、Disallow AI Trainingを選んでも、Bingには学習を断る意思が伝わりません。
今すぐBingでの学習を断りたい場合は、ページに「NOARCHIVE」というメタタグを入れる方法などが案内されています。
作業代行(Agent)には「断る」設定がない
作業代行のAIに向けて「使わないでほしい」と伝える決まった書き方が、まだインターネット全体で整っていないため、今回はAgentにDisallowの設定はありません。Agentは「許可」か「ブロック」から選ぶ形です。
複雑な独自ルールは、自動では読み取られない
Bot Preference Syncは、細かい条件を組み合わせた独自のルールまでは読み取りません。特別な設定をしているサイトは、自動の反映を止めて、robots.txtを自分で管理することもできます。
古い設定は、新しい設定に切り替わる
これまでの「Block AI Bots」は、検索・学習・作業代行を分けた新しい設定に置き換わる予定です。「Managed Robots.txt」もBot Preference Syncに置き換わり、使っていた人は新しい仕組みに移されます。今の設定は自動で引き継がれるので、ほとんどの場合は何もしなくて大丈夫と説明されています。
まとめ
今回の更新で、Cloudflareを使っているサイトは「検索には出したまま、AIの学習だけ断る」を選べるようになりました。無料プランでも使えます。
いちばん気をつけたいのは、「Block」を選ぶと検索にも出なくなったことです。学習だけ止めたいなら「Disallow AI Training」。ここを取り違えると、検索からの訪問が止まってしまいます。
そして、学習を断るかどうかは、ツールではなく会社の方針で決めることです。まずは自社のサイトがCloudflareを使っているかを確かめ、使っているなら、今の設定が何になっているかを一度見ておくのがよさそうです。
参考・情報源
- Cloudflare Blog「Have it both ways: stay discoverable in search while disallowing AI training」(2026年9月15日)
https://blog.cloudflare.com/accountable-mixed-use-ai-crawlers/
※3つの分類、Disallow AI Trainingの仕組み、Accountableの条件と対象の会社、Blockの意味の変更、Bingの対応時期、新しいドメインのおすすめ設定、既存の設定の引き継ぎ、1%未満と17%の数字、対象プランと設定場所の根拠です。 - Cloudflare プレスリリース「Cloudflare Helps End the Search-or-AI-Training Tradeoff」(2026年9月15日)
https://www.cloudflare.com/press/press-releases/2026/cloudflare-helps-end-the-search-or-ai-training-tradeoff/ - Cloudflare Blog「Say it once: introducing Bot Preference Sync」(2026年8月21日)
https://blog.cloudflare.com/bot-preference-sync/
※robots.txtへの書き足し方と、独自ルールを読み取らない点の根拠です。
※記事の内容は2026年9月19日時点で確認できたものです。設定の名前や内容は変わることがあるため、実際に設定するときは公式の案内をご確認ください。




「AIに使われたくない、でも検索からは来てほしい」。
WEB担当者なら一度は聞かれそうな話に、やっと選択肢ができた感じですね。